
A videó egy különleges, új RTX Pro 6000 grafikus kártyát mutat be, amely kiemelkedően nagy, 96 GB VRAM-memóriával rendelkezik, és nehéz beszerezni. A szerző bemutatja, milyen kihívásokkal jár egy ilyen nagy teljesítményű kártya megszerzése, majd szemléletesen összehasonlítja méretét és teljesítményét más népszerű modellekkel, köztük az RTX 5090, RTX 3050 Low Profile, 5060 Ti és Apple M3 Ultra Mac Studio gépekkel.
Az elemzés során szó esik az LLM-ekkel (nagy nyelvi modellekkel) és mesterséges intelligenciával végzett fejlesztések igényeiről, például arról, hogy milyen modelleket lehet futtatni a különféle kártyákon, és hol válnak igazán fontossá a nagy VRAM-kapacitások. Felvetődnek kérdések a memória-méret és a teljesítmény közötti összefüggésekről, illetve arról, hogy mit jelent pontosan a „tokens per second” mérőszám az LLM-futtatásnál, és hogyan befolyásolja ezt a GPU és CPU közötti terhelés megosztása.
A tesztek során számos különböző modellel mérik össze a teljesítményt, beleértve több kvantizációs szintű Llama, Gemma, Mistral és Quen modelleket. A műsorvezető rámutat arra, hogy a különböző kártyák eltérő eredményeket produkálnak a modellek méretétől és típusától függően, és időnként meglepő eredmények is születnek, például amikor egy kisebb memóriájú, de nagyobb számítási kapacitású kártya gyorsabb, mint a „profibb” társai.
Elhangzik, hogy milyen extrém igényeket támaszthatnak a hosszú promtok (akár 35 000 tokenes input), mennyire befolyásolja ezek kezelhetőségét a VRAM-kapacitás, és milyen speciális problémákba ütközhet a felhasználó. Kiemelik azt is, hogy a hasonló erőforrásigényű projekteknél az első tokenig vezető idő, a teljes kontextus hossza, valamint a gép fogyasztása vagy éppen hőtermelése is kritikus szempont lehet.
A videó gondolatébresztő kérdései arra keresik a választ, hogy mikor, kinek és mely felhasználási területekhez éri meg egy ilyen méregdrága, de ritka és nagy VRAM-mal szerelt GPU, illetve hogy milyen kompromisszumokat kell kötni, ha Mac gépekkel vagy más, kisebb memóriájú kártyákkal próbálnánk nagy mesterséges intelligencia modelleket futtatni.
[h]
[t] Skip M3 Ultra & RTX 5090 for LLMs | NEW 96GB KING [/t]
[n] Alex Ziskind [/n]
[k] RTX Pro 6000, RTX 5090, LLM, VRAM, AI, DeepSeek, Gemma, Mistral, Quen, Mac Studio, CUDA, token sebesség, GPU, kvantizáció [/k]
[p] Alex [/p]
[b] Nvidia, Apple, DeepSeek, Gemma, Llama, Mistral, Quen, ChatLM, GPT, Claude, Flux, Cling, Recraft, Luma, Runway, Ideogram [/b]
[s] Nvidia RTX Pro 6000, RTX 5090, RTX 3050 Low Profile, RTX 5060 Ti, Apple M3 Ultra Mac Studio, Apple M4 Max [/s]
[c] technológia [/c]
[/h]
 M4 Max MacBook Pro és ROG Strix SCAR 18: melyik a jobb választás fejlesztőknek?
 128 GB-os mini PC és az LLM modellek új korszaka
 LLM teljesítmény Windows, WSL és Linux alatt: melyik a gyorsabb?
 Mesterséges intelligencia alapú eszköz a hatékony tudáskezelésért
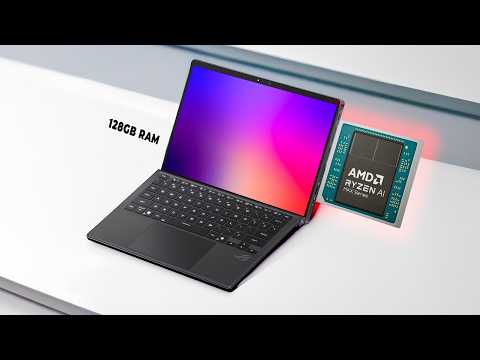 Notebookok új szintje: Az Asus Flow Z13 és az AMD Ryzen AI a nagy nyelvi modellekhez